为什么两个人唱完全相同的一个音,听起来却如此不同?这不是魔法,也不是“嗓子好不好”的问题。这是声学,可以用一个已经被研究了一个多世纪的模型来解释。它叫作声源-滤波器理论,一旦理解了它,您再也不会用原来的方式去听一个声音。
CajaConcepto — 声源 × 滤波器 = 音色
所有歌唱的声音都分两个相互独立的阶段产生:一个产生声音的声源,和一个塑造声音的滤波器。两者相乘的结果,就是您听到的音色。
声源:吉他
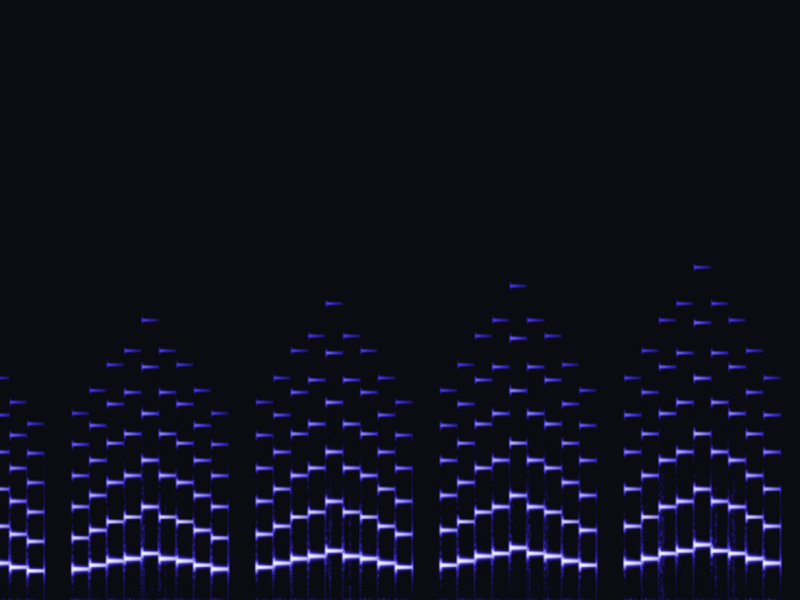
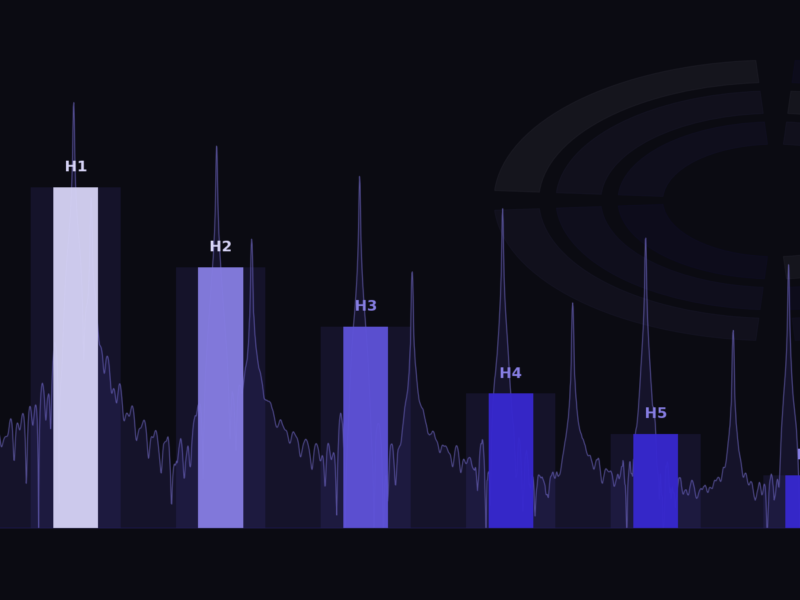
声源是您的声带(也叫声襞)。从肺部上升的气流使它们振动,这种振动产生一个富含谐波的声波:一个基音,伴随着大量是基频整数倍的频率。这和拨动一根吉他弦时发生的事情一模一样:响起的不只是那个音,而是那个音连同它的一整串谐波,正是这些谐波让声音有了厚度。
滤波器:小号
滤波器是您的声道:咽腔、口腔,有时还有鼻腔。它是一根形状不断变化的管道,有其自身的固有共鸣,称为共振峰,会放大声源的某些谐波,减弱另一些。这和小号的原理相同:演奏者嘴唇发出的只是简单的嗡嗡声,金属管把这种嗡嗡声塑造成这件乐器那种辨识度极高的声音。
换元音,就是在移动滤波器
当您换一个音时,您改变的是声源(基频升高或降低),但滤波器,也就是您声道的形状,并不一定随之改变。而当您换一个元音时(比如从 “a” 换到 “u”),情况恰恰相反:您保持同一个音、同一个声源,却彻底改变了滤波器的形状。这就是为什么往高音走时,常常需要“重新调整”口腔和喉咙。声源的频率升高了,而滤波器如果停在原地,就不再与声源对齐。
为什么同一个音,两个声音听起来不一样
答案已经摆在眼前:两个人的声源几乎可以一样(同一个音、相似的声带闭合),听起来却完全不同,因为他们的滤波器,也就是声道的大小和形状,是不同的。这也是为什么即使别人唱同一首歌,您仍然能凭声音认出某个人:声源可以相似,滤波器却是独一无二的。
一个有百余年历史的模型
声源-滤波器理论既不是新想法,也不是歌唱专属:几十年来,它一直是整个言语声学和歌唱嗓音声学中使用最广泛的模型之一。它的力量在于,它把听起来像是一回事的两样东西分开了:您的声音“听起来怎么样”,实际上取决于两个可以分别训练的不同系统。歌手可以练习声源的效率(声带的闭合、气息与声音之间的关系),也可以独立地练习滤波器的形状(舌头放在哪里、下颌张开多少、喉位升高还是降低)。这是通向同一个最终结果的两根不同杠杆。
CajaPruébalo — 用您自己的声音试一分钟
唱一个舒服的音并保持住。不改变这个音,慢慢从元音 “a” 过渡到 “u”,再到 “i”。注意听:音(声源)没有动,但声音的色彩完全变了。您听到的这个变化,就是您的滤波器在实时移动。
Glosario
- 声源 — 嗓音声音的来源:声带的振动。
- 滤波器 — 声道,用其共鸣塑造声源的声音。
- 谐波 — 伴随基音、是其频率整数倍的各个频率。
- 共振峰 — 声道的一种共鸣,会加强特定的频率。
- 音色 — 声音的“颜色”,即使两个人唱同一个音,也能让我们分辨出不同的声音。
Sigue leyendo
想看看您自己的声源和滤波器在整个音域中表现如何吗?分析您的声音 →